Desarrollo
Aprovechamiento de grafos de propiedades del código para la detección de vulnerabilidades


Analista de seguridad
4 min
Como hemos visto en nuestro artículo de revisión anterior, probablemente el enfoque más interesante y exitoso para la detección automatizada de vulnerabilidades sea el basado en patrones. Dado que esperamos extraer patrones significativos a partir del código, también necesitamos una "representación exhaustiva y rica en características" de este. Otros autores han intentado trabajar sobre el código como si fuera una simple colección de palabras o documentos, sin considerar la sintaxis o el orden inherente, pero con resultados deficientes.
Combining standard code representations
La idea básica es analizar sintácticamente (parsear) el código fuente, representarlo como un grafo que amplíe el árbol de sintaxis abstracta (AST) estándar para incluir información sobre el flujo de datos y de control, y almacenarlo en una base de datos que el analista pueda consultar.
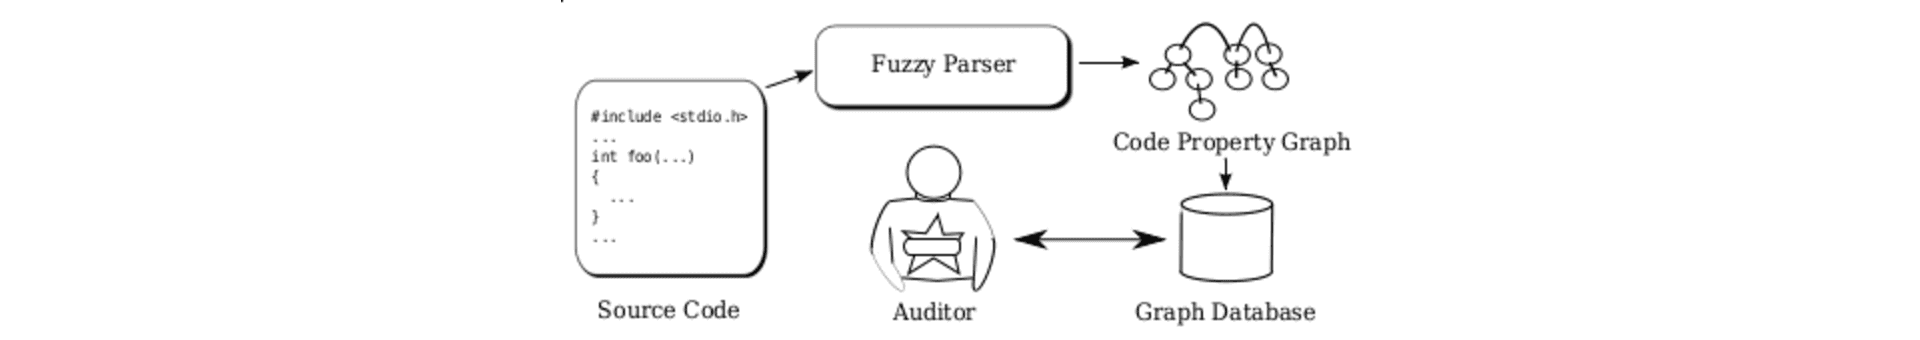
Visión general del proceso.
Además del AST, existen otras representaciones del código que resultan útiles, tales como:
el grafo de flujo de control (CFG, por sus siglas en inglés), que representa el orden en que se ejecutan las instrucciones en función de determinadas condiciones, y
el grafo de dependencia del programa (PDG, por sus siglas en inglés), que indica cómo las instrucciones modifican las variables.
La mejor forma de entenderlas es mediante un ejemplo. Considera el siguiente fragmento de código en C:
In this context, source is meant to be the place in the code where the variables might be tainted by the attacker, and sink is meant to be the function which might be vulnerable if the input from the source is not sanitized. The AST, CFG, and PDG for such a snippet would look like this:

Comparación de representaciones de código mediante grafos.
Ninguno de ellos, por sí solo, puede contarnos la historia completa de lo que ocurre en ese fragmento; algo que, naturalmente, resulta necesario para, identificar vulnerabilidades, dado que estas suelen depender en gran medida del contexto.
Yamaguchi y su equipo proponen la idea de combinar estos tres grafos en un único multigrafo (básicamente, un grafo que permite múltiples aristas para un mismo par de nodos), al que denominan grafo de propiedades del código:

Un grafo de propiedades de código.
En esencia, es como un AST con aristas adicionales "tomadas prestadas" de los PDG y CFG, representadas con diferentes colores y etiquetas. Los autores ofrecen explicaciones detalladas sobre cómo se definen matemáticamente estos grafos, cómo se construyen operacionalmente a partir del código fuente y cómo se recorren posteriormente. Sin embargo, aquí nos centraremos únicamente en la intuición de su funcionamiento, con el descubrimiento de una vulnerabilidad de desbordamiento de búfer en la implementación de SSH de Apple, que expuso a numerosas aplicaciones iOS. Este es el código responsable:
En la línea 3 se asigna memoria mediante la función LIBSSH2_ALLOC, en función del valor de la variable «namelen». El problema radica en que dicha variable está controlada por el usuario; por tanto, si se le asigna un valor lo suficientemente grande, se produce un desbordamiento de búfer («buffer overflow») que podría permitir a un atacante tomar el control de la ejecución del programa. La vulnerabilidad se descubrió originalmente utilizando una expresión regular que busca un patrón en el que el uso de funciones que contienen «ALLOC» se combina con operaciones aritméticas:
Sin embargo, como sabemos, las expresiones regulares no logran captar la estructura anidada del código, pasan por alto el contexto completo que subyace a una situación potencialmente relevante y son propensas a generar falsos positivos. En su lugar, es posible definir un recorrido sobre el grafo de propiedades del código (code property graph) que seleccione aquellos terceros argumentos de memcpy que hayan sido contaminados por primeros argumentos de get_user que, a su vez, no han sido saneados.
Mediante la elaboración manual de dichos recorridos sobre el grafo, los autores lograron identificar 88 vulnerabilidades en el núcleo de Linux. De ellas, 18 eran hasta entonces desconocidas:

Vulnerabilidades de día cero detectadas mediante CPG.
Estamos hablando de 15 CVE, obtenidos a partir de una representación del código en forma de grafo y apenas cuatro recorridos.
Automatización de los recorridos
Por muy buenos que sean los resultados, no resultarían útiles para nuestros fines de investigación si no pudieran automatizarse mediante aprendizaje automático (ML, por sus siglas en inglés). Dado que ya sabemos cómo recorrer el CPG para buscar patrones potencialmente peligrosos, ahora necesitamos una forma de inferir automáticamente cuáles son esos patrones.
No obstante, el procedimiento propuesto por Yamaguchi et al. no es universal; no se aplica a todo tipo de vulnerabilidades, sino a aquellas de tipo «taint» (propagación de datos no validados), como Heartbleed. Además, no está totalmente automatizado: no cabe esperar que, al introducir el código, el sistema detecte todos los errores. En su lugar, es necesario indicarle un «sumidero» (sink) de interés —por ejemplo, memcpy, cuyo uso sin la debida validación provocó Heartbleed
—.Una vez seleccionado un «sumidero» (sink), localizamos todas sus invocaciones, extraemos la parte del programa relacionada con dicho sumidero y la representamos mediante un grafo. Este grafo se divide, a su vez, en llamadas individuales. Posteriormente, esta información se codifica como características —es decir, se proyecta en un espacio vectorial—, lo cual constituye un requisito previo para aplicar cualquier algoritmo de aprendizaje automático (ML). A continuación, estas invocaciones se agrupan (clustering) para identificar conjuntos de llamadas que presentan inicializadores de argumentos similares. No obstante, esto no es suficiente, ya que algunos de dichos argumentos podrían haber sido sometidos a un proceso de saneamiento (sanitization). Por tanto, el penúltimo paso consiste en crear una capa de saneamiento, con el fin de evitar falsos positivos. A continuación, se muestra una representación del proceso:

Agrupamiento para obtener recorridos.
El resultado de este proceso es un conjunto de recorridos en una base de datos de grafos, similares a los descritos en la sección anterior. Estos recorridos siguen una plantilla redactada en Gremlin, el lenguaje de consulta para grafos:
Plantilla para recorridos.
Este método se evaluó utilizando cinco puntos críticos («sinks») vulnerables bien conocidos en cinco proyectos de código abierto distintos, obteniendo buenos resultados. En este caso, la calidad de los resultados se mide por la reducción en la necesidad de realizar auditorías de código manuales; dicha reducción supera el 90 % en todos los casos. Asimismo, se intentó generar un recorrido («traversal») capaz de detectar la vulnerabilidad Heartbleed en OpenSSL, y se llevó a cabo una prueba general en todos los puntos críticos potencialmente susceptibles de recibir datos no validados («taintable sinks») en el reproductor multimedia VLC, lo que permitió descubrir 8 vulnerabilidades hasta entonces desconocidas.
Se trata de una combinación interesante del enfoque de «código como datos» y técnicas de aprendizaje automático (machine learning) para identificar vulnerabilidades en el código fuente (consulte nuestra solución de revisión de código seguro). No obstante, faltan muchos detalles sobre el enfoque basado en patrones para la detección de vulnerabilidades mediante aprendizaje automático. En particular, aún queda por abordar la extrapolación de vulnerabilidades —empleando técnicas de reducción de dimensionalidad— y la detección de comprobaciones faltantes mediante el análisis de anomalías. Permanezca atento para obtener más información sobre la aplicación de esta y otras técnicas de aprendizaje automático al ámbito de la seguridad.
Referencias
Yamaguchi, F., Golde, N., Arp, D., and Rieck, K. (2014). Modeling and discovering vulnerabilities with code property graphs. In Proc. of IEEE Symposium on Security and Privacy (S&P).
Yamaguchi, F., Maier, A., Gascon, H., and Rieck, K. (2015). Automatic inference of search patterns for taint-style vulnerabilities. In Proc. of IEEE Symposium on Security and Privacy (S&P).

Empieza ya con la solución de seguridad de aplicaciones de Fluid Attacks
Etiquetas:
machine-learning
vulnerabilidad
pruebas-de-seguridad
Suscríbete a nuestro boletín
Mantente al día sobre nuestros próximos eventos y los últimos blog posts, advisories y otros recursos interesantes.
Otros posts