
El CVSSF es una métrica de exposición al riesgo creada por Fluid Attacks que convierte un puntaje base CVSS en un valor exponencial mediante la fórmula CVSSF = 4^(CVSS−4). Existe porque la severidad no se suma en línea recta: diez hallazgos de 1.0 no equivalen a uno de 10.0.
La diferencia es aritmética, no retórica. Esos diez hallazgos de severidad baja valen en conjunto cerca de 0,2 unidades CVSSF. El único crítico vale 4.096 unidades CVSSF. En el State of Attacks 2026 de Fluid Attacks, construido sobre 1.119.396 vulnerabilidades reportadas en los sistemas de clientes entre el 1 de enero y el 31 de diciembre de 2025, el 4,5 % que resultó de severidad alta o crítica concentró el 79,9 % de toda la exposición al riesgo reportada.
Esta página cubre qué es el CVSSF, cómo funcionan su fórmula y sus dos constantes, qué mide y qué no mide la métrica, cómo se ubica junto a CVSS, EPSS y el catálogo KEV, y cómo lo usa Fluid Attacks, incluso dentro de un acuerdo de nivel de servicio contractual.
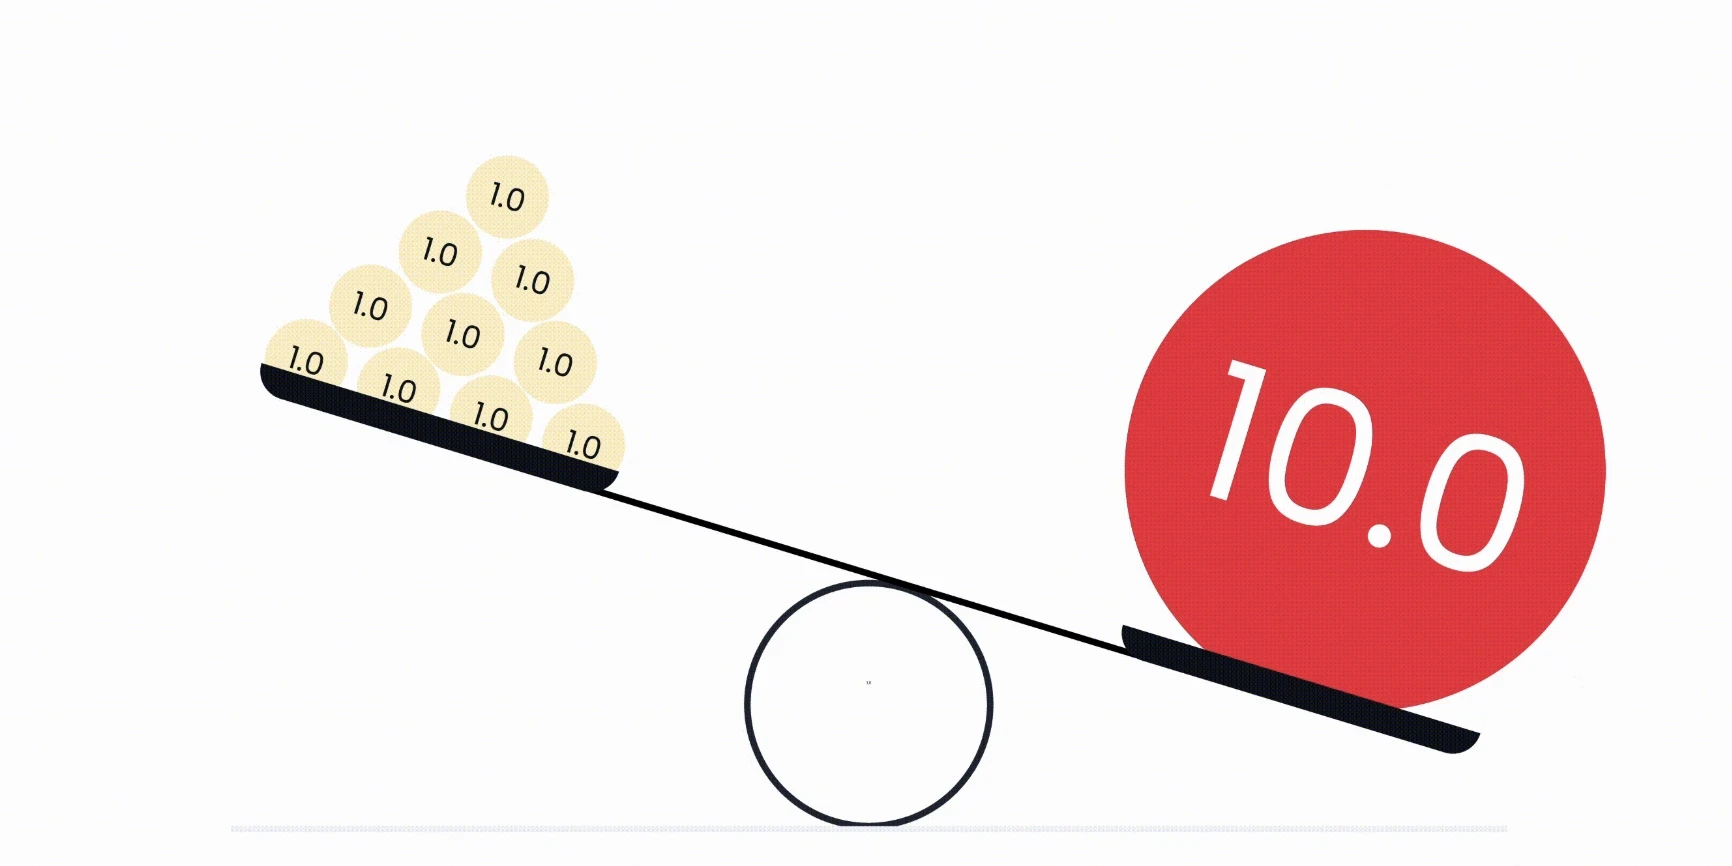
Diez vulnerabilidades de CVSS 1.0 no equivalen a una de CVSS 10.0.
¿Qué es el CVSSF?
El CVSSF es una métrica que expresa cuánta exposición al riesgo agrega una vulnerabilidad a un sistema, en lugar de qué tan grave es esa vulnerabilidad por sí sola. Fluid Attacks lo creó, y su documentación lo define como una transformación del puntaje base CVSS pensada para ayudar a las organizaciones a priorizar la remediación de vulnerabilidades. La “F” viene de “a la Fluid Attaks”.
Responde una pregunta que un puntaje de severidad no puede: cuando sumas todo lo que hay abierto hoy en un sistema, ¿cuánta exposición es eso? Los puntajes CVSS no sobreviven a la suma. Una lista de 400 hallazgos con un promedio de 5.2 no dice nada sobre si el sistema está en problemas, porque el promedio esconde tanto la cola larga como el valor atípico. Un total CVSSF sí lo dice: el agregado CVSSF está construido para que un solo hallazgo crítico pese órdenes de magnitud más que cientos de hallazgos menores.
Tres cosas que el CVSSF no es. No es un estándar: el Forum of Incident Response and Security Teams (FIRST) mantiene CVSS, Fluid Attacks mantiene el CVSSF, y ningún organismo de estandarización lo reconoce. No es una probabilidad, porque una transformación determinista de un puntaje de severidad no dice nada sobre si alguien va a explotar la falla. Y no reemplaza al conteo de vulnerabilidades, que los equipos siguen necesitando para planear capacidad; la priorización de vulnerabilidades funciona mejor con las dos cifras en pantalla. Las preguntas sobre explotación le corresponden a EPSS y al catálogo de vulnerabilidades explotadas conocidas de CISA, que se cubren más abajo.
Cómo se calcula el CVSSF
La fórmula general es CVSSF = P^(CVSS−R), donde P y R son constantes que cada organización elige. Fluid Attacks fija ambas en 4, lo que da la fórmula de trabajo 4^(CVSS−4).
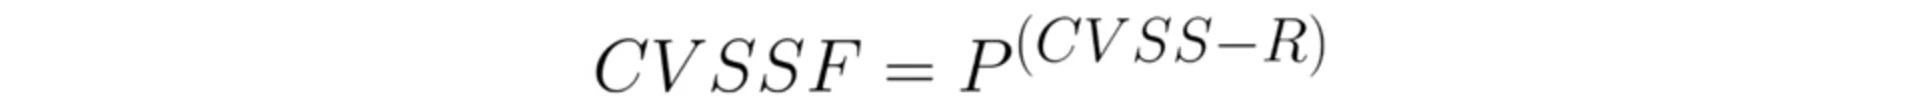
La fórmula general del CVSSF, con sus dos constantes.
La fórmula y sus dos constantes
P significa proporcionalidad. Define cuántas vulnerabilidades de un puntaje base CVSS dado equivalen a una vulnerabilidad con un punto más. Los expertos en seguridad de Fluid Attacks fijaron 4 por consenso, y el valor se publica aquí desde que se introdujo la métrica: cuatro hallazgos de CVSS 9.0 equivalen a uno de 10.0. R significa rango, y ancla la curva para que el resultado se mantenga en cifras con las que un equipo pueda trabajar. Con R en 4, un hallazgo de CVSS 4.0 vale exactamente 1 unidad, y todo lo que está por debajo de ese umbral cae en fracciones.
Esas dos elecciones son los únicos juicios de valor del modelo, y son explícitas a propósito. Una organización que considere que la severidad escala más rápido puede subir P; una que quiera una curva más plana puede bajarla. No hay nada escondido detrás del número.
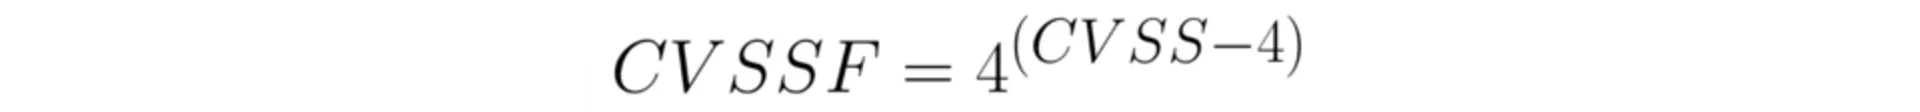
La forma de trabajo del CVSSF que Fluid Attacks aplica a cada hallazgo que reporta.
La escalera de equivalencias
Correr la fórmula a lo largo del rango CVSS hace concreta la curva:
Puntaje base CVSS | CVSSF = 4^(CVSS−4) | Equivalente en hallazgos de CVSS 1.0 |
|---|---|---|
1.0 | 0,02 | 1 |
2.0 | 0,06 | 4 |
3.9 | 0,87 | 56 |
4.0 | 1 | 64 |
5.0 | 4 | 256 |
6.9 | 55,7 | 3.566 |
7.0 | 64 | 4.096 |
8.0 | 256 | 16.384 |
8.9 | 891,4 | 57.052 |
9.0 | 1.024 | 65.536 |
10.0 | 4.096 | 262.144 |
Valores CVSSF a lo largo del rango CVSS, calculados con 4^(CVSS−4). La tercera columna divide cada valor entre las 0,02 unidades de un hallazgo de CVSS 1.0.
Hay dos filas que merecen atención. El salto de 8.9 a 9.0, la línea donde CVSS deja de llamar “alta” a una vulnerabilidad y empieza a llamarla “crítica”, vale 132,6 unidades CVSSF. El salto de 9.0 a 10.0, enteramente dentro de la banda crítica, vale 3.072. La escala cualitativa de severidad cambia en la brecha más pequeña y se queda quieta a lo largo de la más grande.
Un ejemplo trabajado: Log4Shell frente a mil hallazgos de severidad baja
Imagina una organización con 1.000 hallazgos abiertos de CVSS 3.0 y ninguno crítico. El 10 de diciembre de 2021, CVE-2021-44228 aparece en una de sus dependencias. La NVD le asigna un puntaje base CVSS v3.1 de 10.0 y una calificación de severidad crítica.
Por conteo, el backlog pasa de 1.000 a 1.001: un alza del 0,1 %, invisible en cualquier tablero. Por exposición, los 1.000 hallazgos de CVSS 3.0 valen 250 unidades y el nuevo vale 4.096. La exposición total sube más de 1.600 % de un día para otro, y el único hallazgo nuevo concentra el 94 % de ella. Ese es el argumento de la métrica resumido en un evento.
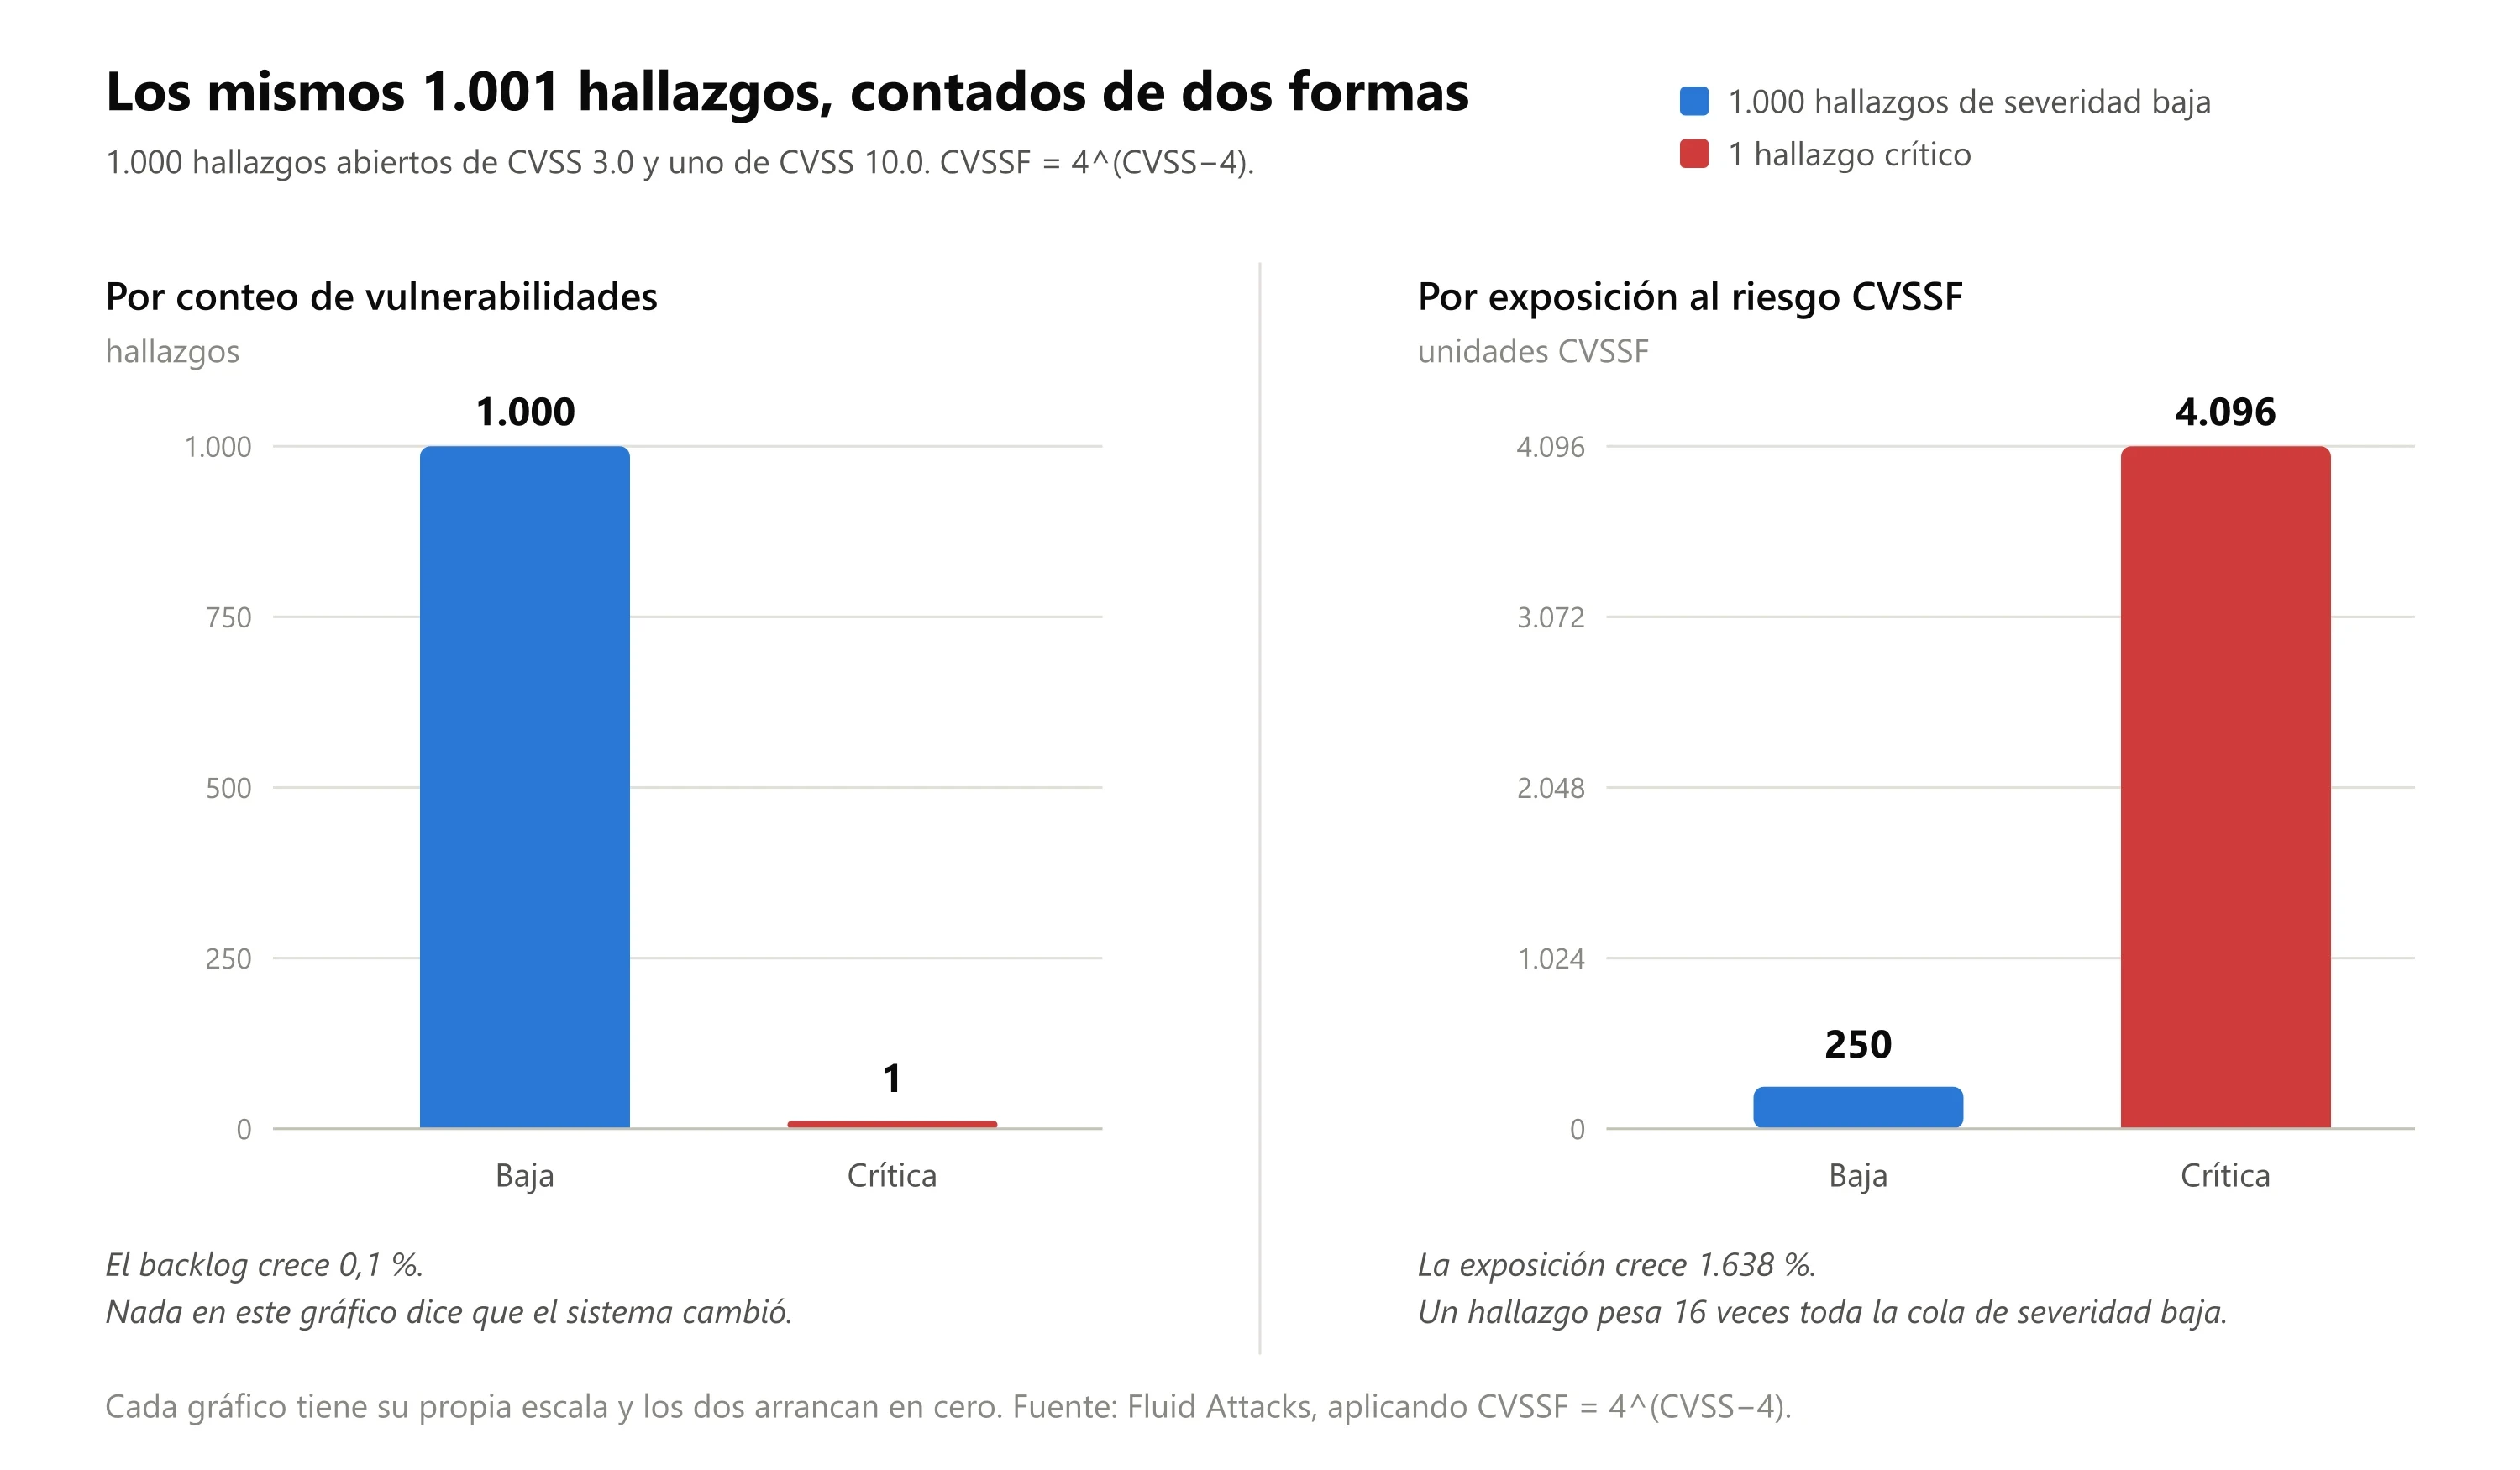
El conteo trata el hallazgo crítico como el 0,1 % del problema. El CVSSF lo pone en 94 %. Elaboración propia.
Dos precisiones. Log4Shell lleva un puntaje CVSS v3.1, mientras que las cifras de 2025 de Fluid Attacks usan rangos de CVSS v4.0, así que los valores producidos bajo distintas versiones de CVSS no deberían compararse sin advertirlo. Y el 4.096 de aquí es el resultado de aplicar la fórmula a un puntaje público, no una calificación oficial publicada para ese CVE.
Por qué contar vulnerabilidades esconde el riesgo
Un conteo de vulnerabilidades trata cada hallazgo como una unidad, que es justo lo que un puntaje de severidad te dice que es falso. Los equipos lo saben, y por eso la mayoría de los programas de gestión de vulnerabilidades agrupa los hallazgos en categorías de severidad baja, media, alta y crítica, y trabaja cada categoría por separado. Eso produce cuatro cifras que no se pueden sumar, y una vista del sistema que nunca se resuelve en una sola respuesta. La gestión de vulnerabilidades basada en riesgo pide una cifra, y un conteo por categorías no puede producirla.
Las bandas de severidad son arbitrarias; la exposición no
Una vulnerabilidad es crítica solo a partir de 9.0, así que una de 8.9 queda etiquetada como alta. Esa diferencia de 0.1 decide cuál se escala, mientras que una de 8.9 y una de 7.0 comparten etiqueta pese a estar separadas por 827,4 unidades CVSSF. Las bandas son un recurso de comunicación, no una medición, y priorizar por ellas significa priorizar por el lugar donde alguien trazó una línea alguna vez.
FIRST lo dice así en su CVSS v4.0 User Guide, en una sección titulada “CVSS Base Score (CVSS-B) Measures Severity, not Risk”. La guía plantea que los puntajes base están diseñados para medir la severidad de una vulnerabilidad, y que el puntaje es independiente de cualquier factor asociado a la amenaza o al entorno de cómputo. La organización que publica el sistema de puntuación es explícita: el puntaje por sí solo no es una cifra de riesgo.
Eso deja una brecha entre lo que CVSS produce y lo que un programa de seguridad tiene que reportar, y el CVSSF es una forma de cerrarla: conservar el trabajo de puntuación que FIRST ya estandarizó, y cambiar la escala sobre la que los resultados se suman.
Qué muestran nuestros datos de 2025
El State of Attacks 2026 de Fluid Attacks cubre 1.119.396 vulnerabilidades reportadas en sistemas de clientes entre el 1 de enero y el 31 de diciembre de 2025, que representan 27.440.146 unidades CVSSF de exposición. El desglose:
Hallazgos de severidad alta y crítica: 50.495 vulnerabilidades, el 4,5 % del total, que concentran el 79,9 % de toda la exposición al riesgo reportada.
Hallazgos de severidad baja: 807.169 vulnerabilidades, el 72,1 % del total, que concentran 29.839 unidades CVSSF, cerca de una milésima parte del agregado.
Sistemas con al menos un hallazgo alto o crítico: 70 %, frente al 53,3 % del año anterior.
El sistema promedio de ese conjunto de datos tenía 1.266 vulnerabilidades y 31.041 unidades CVSSF. Reduce el conteo a la mitad limpiando la cola de severidad baja y la exposición apenas se mueve. La exposición promedio por sistema subió 8,5 % de un año a otro, mientras que la mediana subió 33,5 %, lo que indica que el aumento fue generalizado y no obra de un puñado de valores atípicos.
▶️ Video: explicamos los resultados del Reporte de Ataques 2026 y cómo medimos la exposición al riesgo de los sistemas evaluados.
El CVSSF en Fluid Attacks
Fluid Attacks reporta cada hallazgo con su valor CVSSF, agrega esos valores en la exposición al riesgo agregada que se muestra en toda la plataforma, y mide su propia precisión contra ellos en un SLA contractual. La métrica no es una etiqueta que se añade al final de un reporte: es la unidad en la que se califica el trabajo.
Dónde aparece el CVSSF en la plataforma
En la sección Groups de la plataforma de Fluid Attacks, el resumen de vulnerabilidades de una organización muestra cuatro cifras, y una de ellas es, en palabras de la documentación, “The total CVSSF units corresponding to open vulnerabilities”. Está al lado del conteo de vulnerabilidades abiertas en vez de reemplazarlo, porque las dos responden preguntas distintas: cuánto trabajo hay en fila y cuánta exposición está viva.
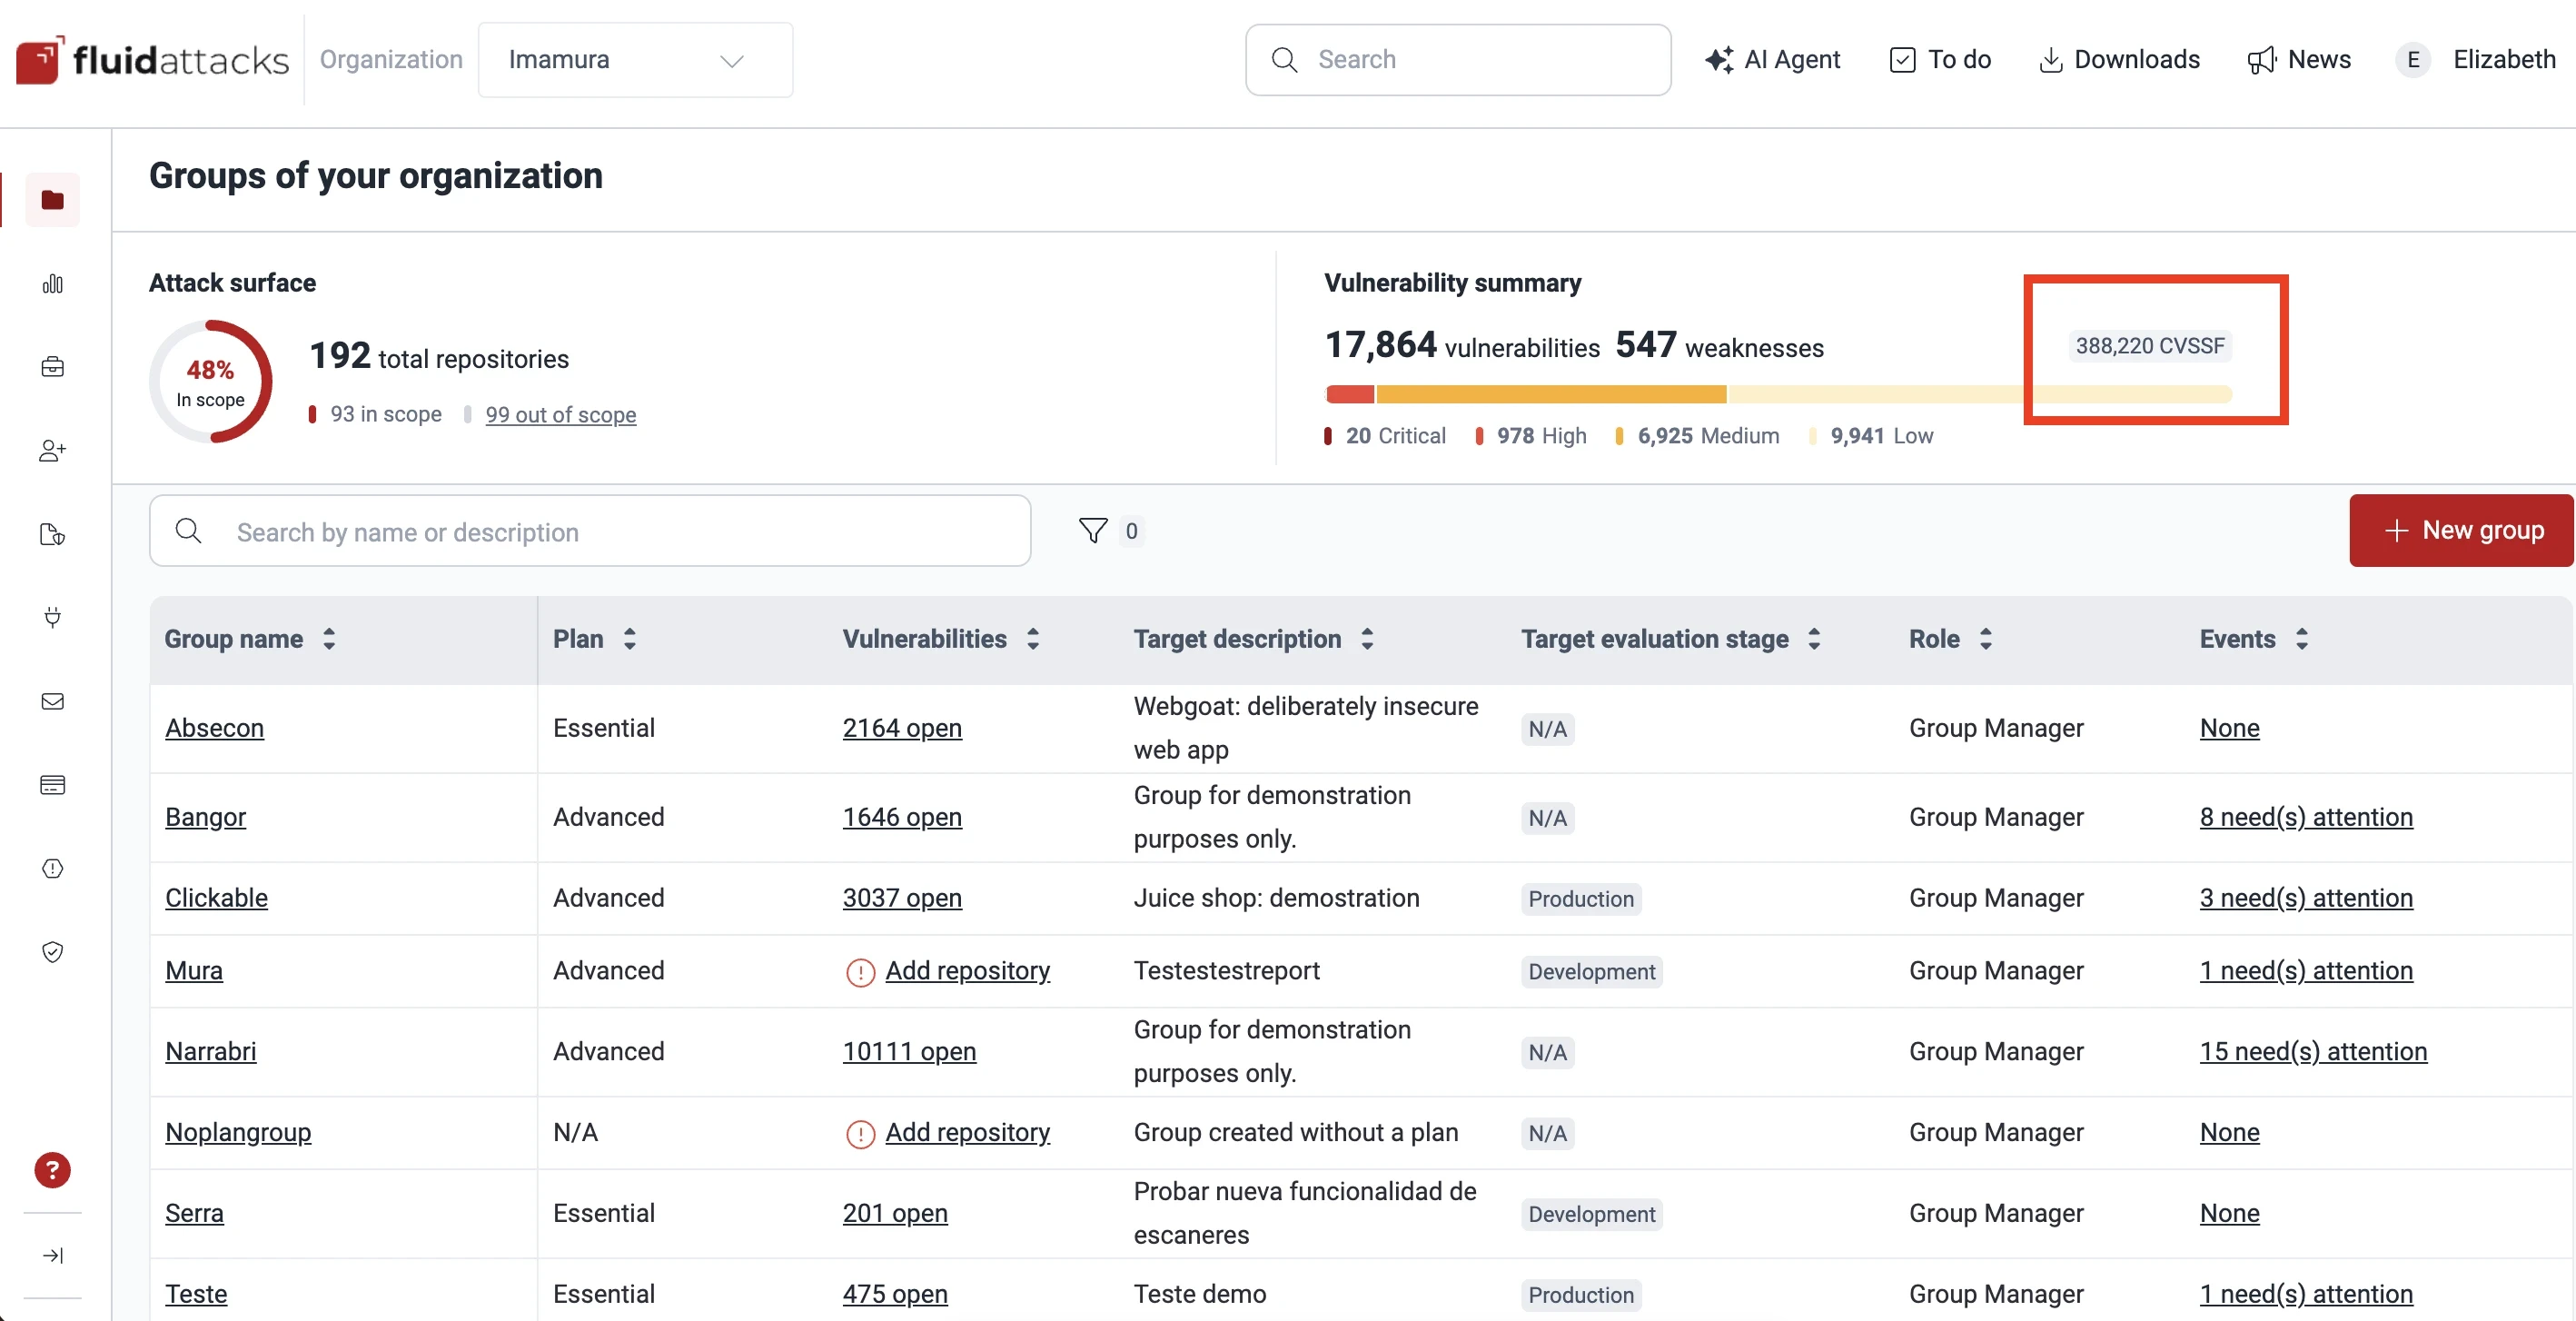
La plataforma muestra el conteo y la exposición lado a lado.
La entrada de ese total se publica de forma abierta. La Fluid Attacks Database lista cada tipo de debilidad con sus métricas base de CVSS 4.0, sus métricas de amenaza y el vector string completo, de modo que cualquiera puede reconstruir el puntaje del que parte un hallazgo de ese tipo antes de juzgar la cifra que produce.
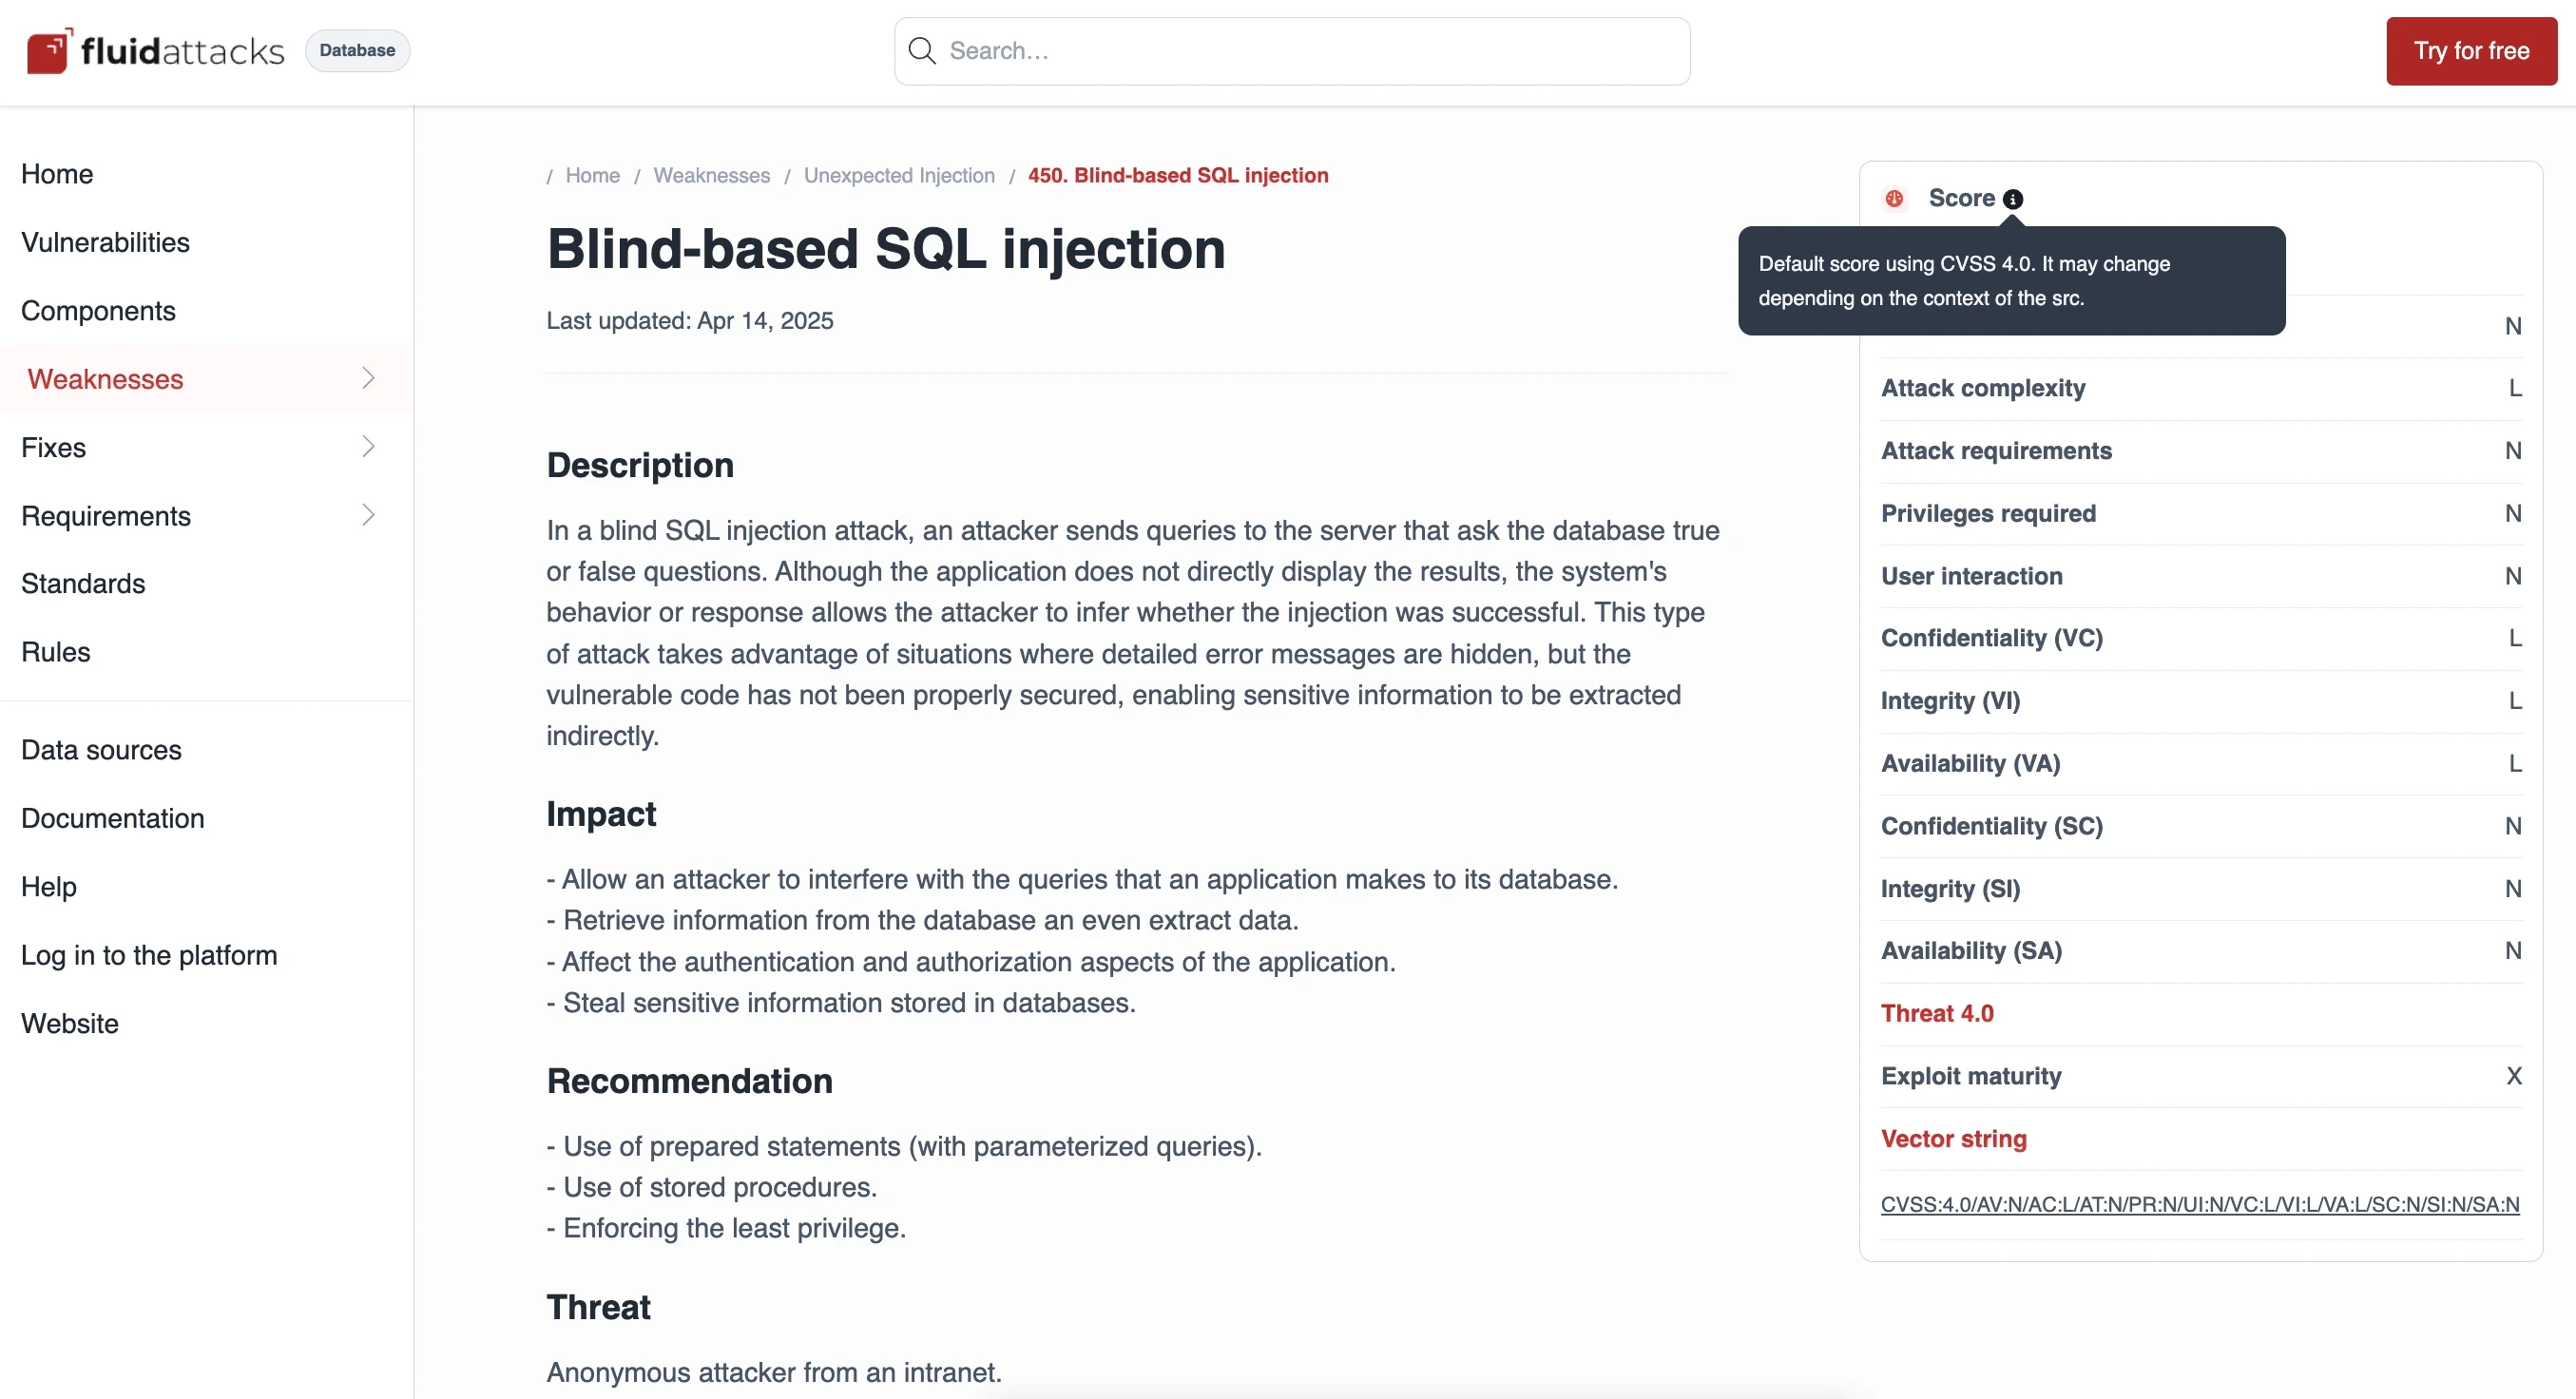
Las métricas base y el vector string publicados para cada tipo de debilidad.
Nuestro Accuracy SLA está escrito en CVSSF
Desde enero de 2025, Fluid Attacks sostiene un Accuracy SLA para los grupos del plan Advanced, con dos umbrales. Los reportes de exposición de un cliente se comprometen a un F2 score de al menos 90 %, y los reportes de sus vulnerabilidades a un F0.5 score de al menos 90 %. La condición de incumplimiento documentada es estrecha: el SLA se rompe cuando las dos precisiones caen por debajo del 90 %.
El primero de esos umbrales se calcula en CVSSF. El procedimiento de la documentación es explícito: calcular el valor de cada vulnerabilidad con 4^(CVSS−4), totalizar las cifras de los verdaderos positivos, los falsos positivos y los falsos negativos, derivar precisión y recall de esos totales, y aplicar la fórmula del F2. El F2 le da más peso al recall que a la precisión, así que la medida castiga mucho más un hallazgo crítico omitido que una falsa alarma, que es la forma correcta para una cifra en la que un equipo de seguridad tiene que confiar.
El segundo umbral usa conteos simples de vulnerabilidades y un F0.5 score, que pondera la precisión. Un compromiso protege a quienes gestionan el riesgo; el otro protege a los desarrolladores que trabajan la fila.
Pruebas manuales y automatizadas, medidas en CVSSF
Cambiar la unidad de medida cambia lo que los resultados dicen sobre los métodos de pruebas de seguridad. Pruebas manuales aquí significa pentesting realizado por los pentesters de Fluid Attacks. Del State of Attacks 2026:
Medida | Herramientas automatizadas | Pruebas manuales |
|---|---|---|
Porcentaje de vulnerabilidades halladas | 88,4 % | 11,6 % |
Porcentaje de exposición hallada | 55,8 % | 44,2 % |
CVSSF promedio por hallazgo | 15,5 | 93,2 |
Las cifras de herramientas cubren los planes Advanced y Essential; las de pruebas manuales cubren solo el plan Advanced. State of Attacks 2026, datos de 2025.
Por conteo, la automatización hace casi nueve décimas partes del trabajo. Por exposición, hace un poco más de la mitad. Un hallazgo reportado por un pentester concentró seis veces la exposición de uno reportado por un escáner en ese conjunto de datos.
La cifra que preferiríamos no publicar
En el benchmark de Fluid Attacks de 36 herramientas AppSec de terceros contra una aplicación web deliberadamente vulnerable con 1.201 vulnerabilidades conocidas en 105 categorías CWE, 461.500 unidades CVSSF en total, el escáner propio de Fluid Attacks obtuvo el mejor recall automatizado con 22,7 % y una precisión del 99 %. Ponderado por exposición, ese mismo escáner llegó a un 8,8 % de recall. La mejor herramienta de terceros de la tabla publicada llegó a 7,0 %, y el benchmark advierte que el recall ponderado por exposición de las 37 herramientas evaluadas, sumado, no alcanzaría el 60 % del total.
El pentester del mismo estudio encontró 1.076 de las 1.201 vulnerabilidades sin un solo falso positivo: 89,6 % de recall, y 98,9 % una vez ponderado por exposición. Los 743 hallazgos que ninguna herramienta automatizada detectó, el 61,9 % del universo, concentraron el 86,8 % de la exposición al riesgo total.
Leído sin adornos, eso juega en contra de la automatización, la nuestra incluida. Un escaneo limpio no es evidencia de una aplicación segura: es evidencia de que la capa rápida terminó. Esta es la segunda razón por la que la métrica importa: saca a la superficie los falsos negativos que un conteo de vulnerabilidades tapa, porque los hallazgos que un escáner omite son desproporcionadamente los caros.
Qué no te dice la métrica
La métrica transforma severidad. No sabe si una función vulnerable es alcanzable, si la entrada está controlada por el atacante, o si alguien está explotando la falla hoy. El relato de Fluid Attacks sobre cómo se validan los hallazgos de análisis estático asistido por IA describe a investigadores que recorren el flujo de origen a destino y reproducen el problema localmente antes de confirmarlo, un trabajo que ningún puntaje hace por ti. Un 4.096 sobre una ruta inalcanzable sigue siendo un 4.096, y solo el contexto te dice lo contrario.
CVSSF, CVSS, EPSS y KEV no son alternativas
Estos cuatro responden cuatro preguntas distintas, y un proceso de priorización que usa solo uno de ellos se queda sin la información que cargan los otros.
Métrica | Pregunta que responde | Mantenida por | Rango |
|---|---|---|---|
Puntaje base CVSS | ¿Qué tan grave es esta vulnerabilidad en abstracto? | FIRST | 0.0 – 10.0 |
CVSSF | ¿Cuánto agrega a la exposición al riesgo agregada? | Fluid Attacks | ≈0,005 – 4.096 |
EPSS | ¿Qué tan probable es su explotación en los próximos 30 días? | FIRST | 0 – 1 |
KEV | ¿Hay evidencia de explotación en el mundo real? | CISA | Sí / No |
Qué mide cada métrica y quién la mantiene.
CVSS es la entrada y el CVSSF es la agregación, así que los dos son secuenciales y no competidores. EPSS, también de FIRST, estima la probabilidad de explotación a partir de datos observados. El catálogo de vulnerabilidades explotadas conocidas de CISA registra lo que los atacantes están usando ahora mismo, y sus tres criterios de inclusión son públicos: la vulnerabilidad tiene un identificador CVE asignado, hay evidencia confiable de explotación activa en el mundo real, y existe una acción de remediación clara.
Una entrada del KEV con un puntaje CVSS moderado puede merecer atención antes que un 9.8 que nadie está explotando. El CVSSF te dice cuánta exposición hay sobre la mesa; los otros dos te dicen qué tan rápido es probable que se cobre. Emparejar la métrica con ambos sale barato, porque son entradas independientes al mismo ordenamiento.
▶️ Video: explicamos por qué el estándar CVSS se queda corto para dimensionar el riesgo y cómo la métrica CVSSF cubre esa diferencia.
Cómo poner el CVSSF a trabajar
Empieza por reportar exposición y conteo lado a lado, no uno en lugar del otro. La gestión de vulnerabilidades basada en riesgo necesita los dos: el conteo para planear capacidad, y el CVSSF para decidir el orden. Reemplazar uno por el otro cambia un punto ciego conocido por uno nuevo.
Fija tu propio P y después déjalo quieto: Fluid Attacks usa 4 porque sus expertos convergieron en ese valor, y la constante está publicada para que cualquiera pueda estar en desacuerdo. Elige el valor que coincida con cómo tu organización pondera un punto más de severidad, escribe el razonamiento, y mantenlo estable: una curva que cambia cada trimestre vuelve insignificantes las tendencias.
Haz seguimiento a la exposición abierta en el tiempo, no a la exposición cerrada: las cifras de remediación se ven mejor cuando los equipos limpian hallazgos de severidad baja en lote. El CVSSF abierto solo se mueve cuando se arregla algo que importaba.
Fija metas de remediación de vulnerabilidades en CVSSF, no en porcentaje de hallazgos cerrados: “reducir la exposición abierta un 60 % este trimestre” sobrevive al contacto con un backlog. “Cerrar el 60 % de los hallazgos” es una meta que un equipo puede cumplir dejando abierto cada problema crítico.
Cruza la cabeza de la lista con señales de explotabilidad: ordena por CVSSF y después contrasta los hallazgos de arriba contra los datos de explotación y el catálogo KEV. La métrica ordena la fila; la evidencia de explotabilidad decide quién se la salta.
Cuenta con que las omisiones dominen tu presupuesto de error: si tu escáner de mayor recall encuentra menos de una décima parte de tu exposición CVSSF, la brecha no se cierra afinándolo. Se cierra sumando pentesting manual encima, que Fluid Attacks entrega como Pentesting as a Service (PTaaS).
Conclusiones
El CVSSF es una idea pequeña con una consecuencia grande. Elevar 4 a la potencia de un puntaje CVSS menos 4 convierte una etiqueta de severidad en una cantidad que se puede sumar, comparar entre sistemas y seguir en el tiempo, que es lo que todo programa de seguridad necesita y lo que un conteo de vulnerabilidades nunca entregó. La remediación de vulnerabilidades deja de ser una fila que hay que vaciar y pasa a ser una cifra CVSSF que hay que mover.
El costo de no medir así aparece en los propios datos de 2025 de Fluid Attacks: el 4,5 % de los hallazgos concentró el 79,9 % de la exposición total, así que un programa calificado por conteo estaba calificando el 95,5 % que casi no importaba. El límite del CVSSF es igual de claro. Ordena exposición, no probabilidad, y hereda lo que un puntaje CVSS haya acertado o errado. Usado junto a EPSS y al catálogo KEV, el CVSSF le da a una fila de remediación un orden que se sostiene cuando alguien pregunta por qué. Dos cifras CVSSF, la exposición abierta de ahora y la de hace un trimestre, dicen más sobre un programa de seguridad que cualquier conteo de hallazgos.
Preguntas frecuentes
¿Cuál es la fórmula del CVSSF?
La fórmula del CVSSF es 4^(CVSS−4), un caso específico de la forma general P^(CVSS−R) con ambas constantes fijadas en 4. Un hallazgo de CVSS 4.0 vale 1 unidad, uno de 7.0 vale 64, uno de 9.0 vale 1.024, y uno de 10.0 vale 4.096. Por debajo de 4.0 los valores son fracciones: un hallazgo de CVSS 1.0 vale 0,02 unidades, así que diez de ellos suman cerca de 0,2.
¿El CVSSF es un estándar de seguridad como CVSS?
No. Fluid Attacks creó y mantiene el CVSSF, mientras que FIRST mantiene CVSS, y ningún organismo de estandarización lo reconoce. Es una transformación que se aplica a un puntaje CVSS, lo que significa que depende de CVSS en lugar de competir con él. Trátalo como una métrica de reporte y priorización de vulnerabilidades con una fórmula publicada, no como un estándar de la industria.
¿En qué se diferencia el CVSSF de EPSS?
El CVSSF mide cuánta exposición al riesgo aporta una vulnerabilidad; EPSS estima qué tan probable es que se explote dentro de 30 días. Uno es una función determinista de una calificación de severidad, el otro una probabilidad derivada de datos de explotación observados. Se contradicen con frecuencia y de forma útil: un hallazgo de alta exposición que nadie está explotando puede esperar detrás de uno moderado que figura en el catálogo KEV de CISA.
¿Un conteo de vulnerabilidades más bajo significa menos riesgo?
No, y los propios datos de Fluid Attacks muestran por qué. De 1.119.396 vulnerabilidades reportadas en sistemas de clientes durante 2025, el 4,5 % calificado como alto o crítico concentró el 79,9 % de la exposición al riesgo total, mientras que el 72,1 % calificado como bajo concentró cerca de una milésima parte. Un equipo que cierra cientos de hallazgos de severidad baja puede recortar su conteo de forma marcada y dejar su exposición prácticamente igual.
¿Fluid Attacks usa el CVSSF en sus acuerdos de nivel de servicio?
Sí. El Accuracy SLA, vigente desde enero de 2025 para el plan Advanced, compromete los reportes de exposición al riesgo a un F2 score de al menos 90 %, calculado totalizando los valores CVSSF de los verdaderos positivos, los falsos positivos y los falsos negativos. Un segundo umbral compromete los reportes de vulnerabilidades a un F0.5 score de al menos 90 % sobre conteos simples, y el SLA se incumple cuando los dos caen por debajo del 90 %.
Mide la exposición, no la fila
Nuestra IA, nuestros escáneres y nuestros pentesters reportan cada hallazgo con su valor CVSSF, para que tu equipo arregle lo que mueve la cifra en lugar de vaciar un backlog. Prueba gratuita · Contáctanos

Empieza ya con la solución de RBVM de Fluid Attacks













